ODCC技术 | 高性能SSD加速MoE模型推理
随着大语言模型(LLM)参数规模持续攀升,混合专家(Mixture-of-Experts, MoE)架构已成为高效扩展模型能力的核心范式。从DeepSeek-R1、Kimi-K3、DeepSeek-V4到Qwen3.8-Max-Preview,业界旗舰模型几乎全面采用MoE设计。MoE通过稀疏激活机制,在增大参数量的同时使模型只需要较低的算力。然而,MoE架构在带来计算效率优势的同时,也引入了严峻的内存挑战。以DeepSeek-R1-671B为例,其总参数量高达671B,如果将模型完整部署在GPU HBM中,使用FB16精度需要的显存约为1.34TB,需要使用17张A100(80GB)GPU,这带来了较高硬件成本。
在此背景下,MoE Offloading推理框架应运而生。其核心思路是利用MoE的稀疏性特征——推理时仅激活少量专家——将未激活的专家权重卸载(Offload)至SSD中存储,仅在推理过程中按需将所需专家传输至GPU。这一策略使得即便在有限的GPU显存条件下,也能实现对万亿参数级模型的推理服务,大幅降低了总体拥有成本(TCO)。但另一面,Offloading方案将推理性能瓶颈从计算转移到了SSD到GPU的数据传输路径上。每一个token的推理都可能需要从SSD中随机读取不同专家的权重,对SSD的随机读性能(Random Read) 提出了极高要求。通过增加SSD的通道数来提升SSD的性能成为一种可靠方案。16通道高性能SSD相较于传统8通道SSD,在随机读IOPS上实现大幅提升,直接转化为MoE Offloading推理Prefill阶段吞吐量的显著增益。
01 背景
MoE的稀疏性与内存困境:MoE模型的核心结构由门控网络(Gating Network)和一组专家(Experts)组成。在每一个MoE层中,门控网络根据输入token的特征,将其路由至少量(通常为2~8个)专家进行计算,其余专家保持休眠状态。这种稀疏激活机制使得实际参与计算的参数量(激活参数)远小于总参数量,从而大幅降低了FLOPs需求。以DeepSeek-R1-671B为例,该模型包含数千个专家,总参数量为671B,但每次推理仅激活约37B参数。从计算角度考虑,每次前向传播仅需约37B参数的计算量,计算成本接近一个37B的稠密模型。但从存储角度考虑,所有671B参数必须在推理时可用,否则无法响应不同token路由到不同专家的需求。所有参数以FP16精度存储并全部置于GPU HBM中,所需显存约为1.34 TB,至少需要17块以上的80GB GPU才能承载全部权重,再加上KV Cache、激活值的额外开销,实际显存需求将更高,这显著地增加了硬件成本。
MoE Offloading推理框架:为突破显存瓶颈,MoE Offloading推理框架(如DeepSpeed)采用了一种"分层存储 + 按需加载"的策略。其中SSD层存储全部(或绝大部分)专家权重,作为模型的"冷存储池"。GPU层仅保留当前推理步骤所需激活的专家、共享层参数(注意力层、嵌入层等)以及KV Cache。推理过程中,框架根据门控网络的路由决策,从SSD中读取对应专家的权重并传输至GPU完成计算。由于MoE的稀疏性,每次推理仅需要从SSD中读取少量专家(通常占总专家数的2%~5%),因此SSD的带宽和IOPS成为决定推理延迟的关键因素。以DeepSeek-R1-671B为例,采用FP16精度模型总大小约为1.34 TB,SSD需要至少提供这一容量。GPU侧需要存储的包括:激活参数(约74GB)以及KV Cache(取决于序列长度和batch size)。这意味着,使用1~2块48GB的GPU(如NVIDIA L20)即可实现671B参数模型的推理,硬件成本降低了近一个数量级。
02 实验
为验证16通道高性能SSD在MoE Offloading推理场景中的加速效果,我们基于DeepSpeed框架,使用DeepSeek-R1-671B模型进行了系统性的性能对比测试。测试模拟了真实生产环境中多并发推理的场景,同时运行4个MoE Offloading推理进程,对比16通道SSD与8通道SSD两种方案。设置两种SSD部署方式:1)Single SSD(单盘共享):4个推理进程共享同一块SSD。该场景模拟单节点单盘部署,对SSD的并发随机读能力要求极高。2)Shared RAID(RAID0共享):4块SSD组合为RAID0条带设备,4个推理进程共享。该场景模拟多盘聚合部署,通过条带化提升带宽,同时考验多盘协同下的随机读性能。
在畅快算与三星电子的联合测试中,使用不同的输入序列长度,以评估16通道SSD随机读提升带来的实际收益。评估平台使用双CPU,4卡GPU,1TB DDR5内存,系统使用ubuntu22.04.内核使用6.8.0.结果显示,16通道相较8通道SSD随机读性能提升65% (3300K IOPS vs 2000K IOPS)的情况下,16通道SSD可以可带来约16%~18%的MoE Offloading推理Prefill吞吐量提升。
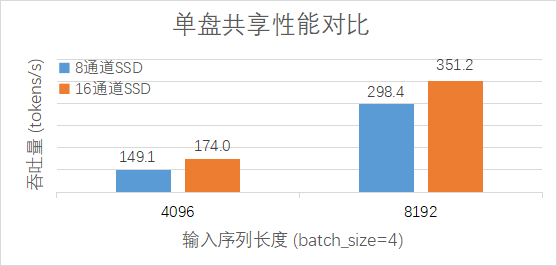
图1:MoE offloading使用单盘共享性能对比
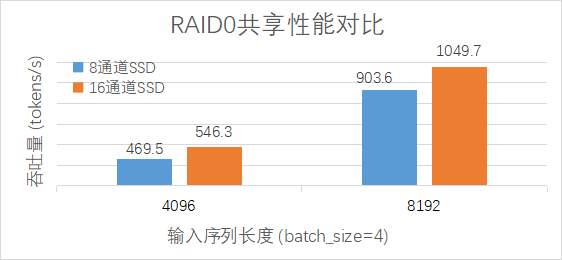
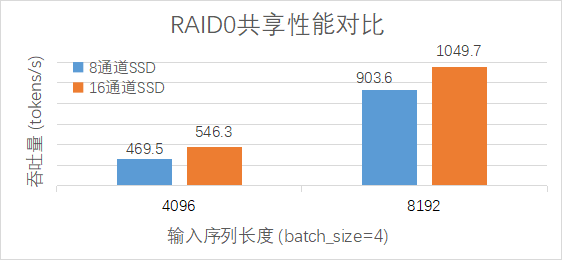
图2:MoE offloading使用RAID0共享性能对比
03 总结
MoE Offloading推理框架为万亿参数级大模型的普惠化部署提供了一条务实路径——通过"SSD存专家、GPU算专家"的分层架构,将GPU显存需求从数成百上千GB压缩至数十GB,使消费级或中端GPU即可承载旗舰级模型。然而,这一方案将性能瓶颈从GPU计算转移到了SSD随机读I/O上,SSD的随机读性能直接决定了推理服务的吞吐量上限。本次测试清晰表明:16通道高性能SSD凭借65%随机读IOPS优势,可带来约16%~18%的MoE Offloading推理Prefill吞吐量提升。在AI推理服务日益成为核心生产负载的今天,SSD已不再仅仅是"大容量冷存储"的角色,而是逐步演变为AI推理系统中的性能关键组件。
展望未来,随着MoE模型参数规模向十万亿级迈进,以及推理框架对SSD I/O路径的持续优化,SSD的通道数、随机读IOPS和带宽将持续成为AI存储选型的核心考量指标。高性能SSD的引入,正是存储行业顺应AI推理需求演进、从"容量驱动"向"性能驱动"转型的标志性一步。
作者
赵凯 cayre_zhao@smoothcompute.com
刘明 henry_liu@smoothcompute.com
李吉庆 ethan.li@smoothcompute.com
郑永宰 yj1004.jung@samsung.com
金容焕 yh2015.kim@samsung.com
王丽翠 amy.wang@samsung.com
董丽娟 vita.dong@samsung.com
司洲 zhou.si@samsung.com
段世茹 duanshiru@caict.ac.cn
参考资料
畅快算信息产业官网
https://www.smoothcompute.com/
三星半导体官网
https://semiconductor.samsung.com/cn/
*本文中的产品图片以及型号、数据、功能、性能、规格参数等仅供参考,畅快算和三星电子有可能对上述内容进行改进,具体信息请参照产品实物、产品说明书或畅快算信息产业官网(https://www.smoothcompute.com/)和三星半导体官网(https://semiconductor.samsung.com/cn/)。除非经特殊说明,本网站中所涉及的数据均为畅快算和三星电子内部测试结果。