ASC分享 | 阿里云孔阳:以UMX统一内存扩展 破解AI Scale-Up“容量墙”
近日,2026先进存力大会在上海举行。会上,阿里云服务器研发超高速互连负责人孔阳发表《基于UMX统一内存/存储扩展的AI Scale-Up架构》主题演讲,围绕Agent时代大模型推理的容量、带宽与时延挑战,系统分析KV Cache对算力基础设施的重塑作用,并分享阿里云依托磐久AL144超节点、开放互连和分层资源池开展的UMX统一内存扩展实践,为下一代智算系统建设提供新的技术路径参考。
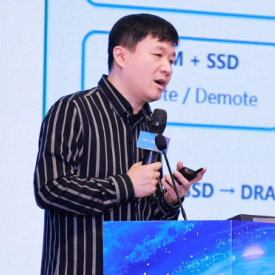
孔阳
阿里云服务器研发超高速互连负责人
1 负载演进: Agent持续提升内促需求
随着人工智能从单轮对话向工具调用、长上下文、多Agent协同和状态持续保存演进,推理系统的资源需求发生显著变化。传统大模型服务主要关注单次计算效率,新一代Agent则需要在更长周期内反复读取历史状态、复用公共前缀并协调多个任务。上下文长度、并发规模、RAG数据量和多模态输入同步增长,使KV Cache快速膨胀,逐步成为影响服务规模、首Token时延和系统成本的关键资源。
阿里云围绕主流推理引擎构建KV Cache管理能力,形成L1 HBM、L2主机内存、L2.5内存池和L3共享存储的多级架构,并以KVCM、MoonCake SDK、HF3FS SDK等组件衔接不同层级。结合Prefix Cache、P/D分离及GPU到RDMA、GPU到DRAM的数据路径优化,系统能够提高公共前缀和历史状态的复用效率,缩短外部KV Cache访问链路。据介绍,阿里云Tair KVCM缓存有效命中率可达99%,同时每Token成本下降50%。
孔阳指出,预填充阶段以计算密集为主,解码阶段则需要持续读取模型权重和KV Cache,系统瓶颈由单一算力约束转向内存容量与访问带宽约束。仅依靠GPU HBM承载全部状态,不仅面临容量上限,也会带来显著的成本与功耗压力。如何把可复用状态高效留存,并在需要时快速送达GPU,已经成为Scale-Up架构必须解决的新问题。
2 竞争维度升级:Scale-Up从扩算力走向扩容量、扩带宽
面向长上下文与高并发推理,Scale-Up系统的核心能力正在由“连接更多GPU”扩展为计算、专家路由、内存容量和数据供给能力的综合协同。孔阳表示,算力只有在数据能够及时到达时才能被充分利用;如果KV Cache迁移速度跟不上计算节奏,GPU规模继续扩大也可能因等待数据而降低整体效率。
为此,AI基础设施需要改变计算资源与容量资源绑定扩展的方式,使两者能够按业务负载独立配置、弹性增长。在超节点内部,高带宽、低时延互连仍用于保障GPU之间的紧密协作;在超节点外部,则需要引入可扩展的内存与存储资源池,承接冷数据、公共前缀和可复用状态,从而在性能与单位容量成本之间形成更合理的平衡。
3 架构重构:以UMX连接多级内存与存储资源池
针对上述挑战,演讲提出UMX统一内存扩展体系。该体系以一致的Load/Store访问语义为基础,通过UALink、CXL等开放互连,将GPU HBM、主机DRAM、远端内存、SCM及共享存储组织为分层资源池,使热数据驻留在距离GPU更近的层级,冷数据和可复用状态进入更具容量与成本优势的层级,并通过直接访问、批量搬移、零拷贝、流水处理以及计算通信重叠降低迁移开销。
报告展示的阶段性实测结果显示,两级缓存方案下系统吞吐提升58.3%,P90首Token时延下降48.7%。相关结果表明,统一内存扩展不仅能够缓解KV Cache容量压力,也有望通过提升复用效率、缩短数据路径改善推理体验。该数据来自特定测试环境,后续仍需结合模型结构、上下文长度、并发规模和访问局部性持续验证。
孔阳表示,Agent时代的AI基础设施将从“以计算为中心”进一步走向计算、内存、存储与网络协同设计。未来,阿里云将继续联合产业伙伴推进开放互连、软硬协同与场景验证,推动Scale-Up系统从单纯扩展算力,升级为同时扩展状态容量和数据供给能力的开放平台,为长上下文推理、多Agent系统及下一代AI服务构建高性能、低成本、可扩展的基础设施底座。