ASC分享 | 绿算技术黄飞:KV Cache 落在哪一层,比落在哪种介质更重要
10月21日,2026先进存力大会(ASC)召开。当日下午的存储系统专题上,绿算技术市场营销管理中心总经理黄飞将带来《KV Cache 分层落点对比》主题演讲。底稿是一份刚跑完的实测报告:在绿算 GP7000 全闪 NVMe-oF 阵列上,用 DeepSeek-V4-Flash 与 vLLM 聚合集群,把同一份 KV Cache 分别落在“纯 DRAM”与“DRAM + 全闪”两个位置逐项对比。
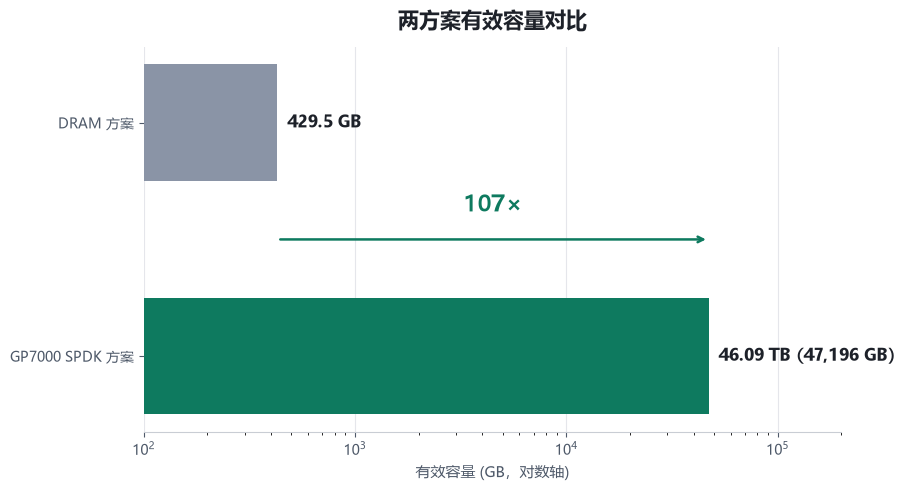
结论先放在前面——两种落点的吞吐打平,有效容量相差 107 倍。
一个被问反了的问题
“KV Cache 放内存还是放闪存?”行业里的答案往往停在直觉:DRAM 快、闪存慢,能放内存就别放盘。这个问法默认二者差别主要在“读得有多快”。
实测不是这样。纯读路径上,两种落点的吞吐比落在 0.97–1.03×,属于噪声量级。分水岭不在速度,而在容量——以及容量耗尽之后系统会发生什么。
黄飞的切入点是:不问“哪种介质更快”,而问“KV 该落在哪一层”。
同一张拓扑,两种落点
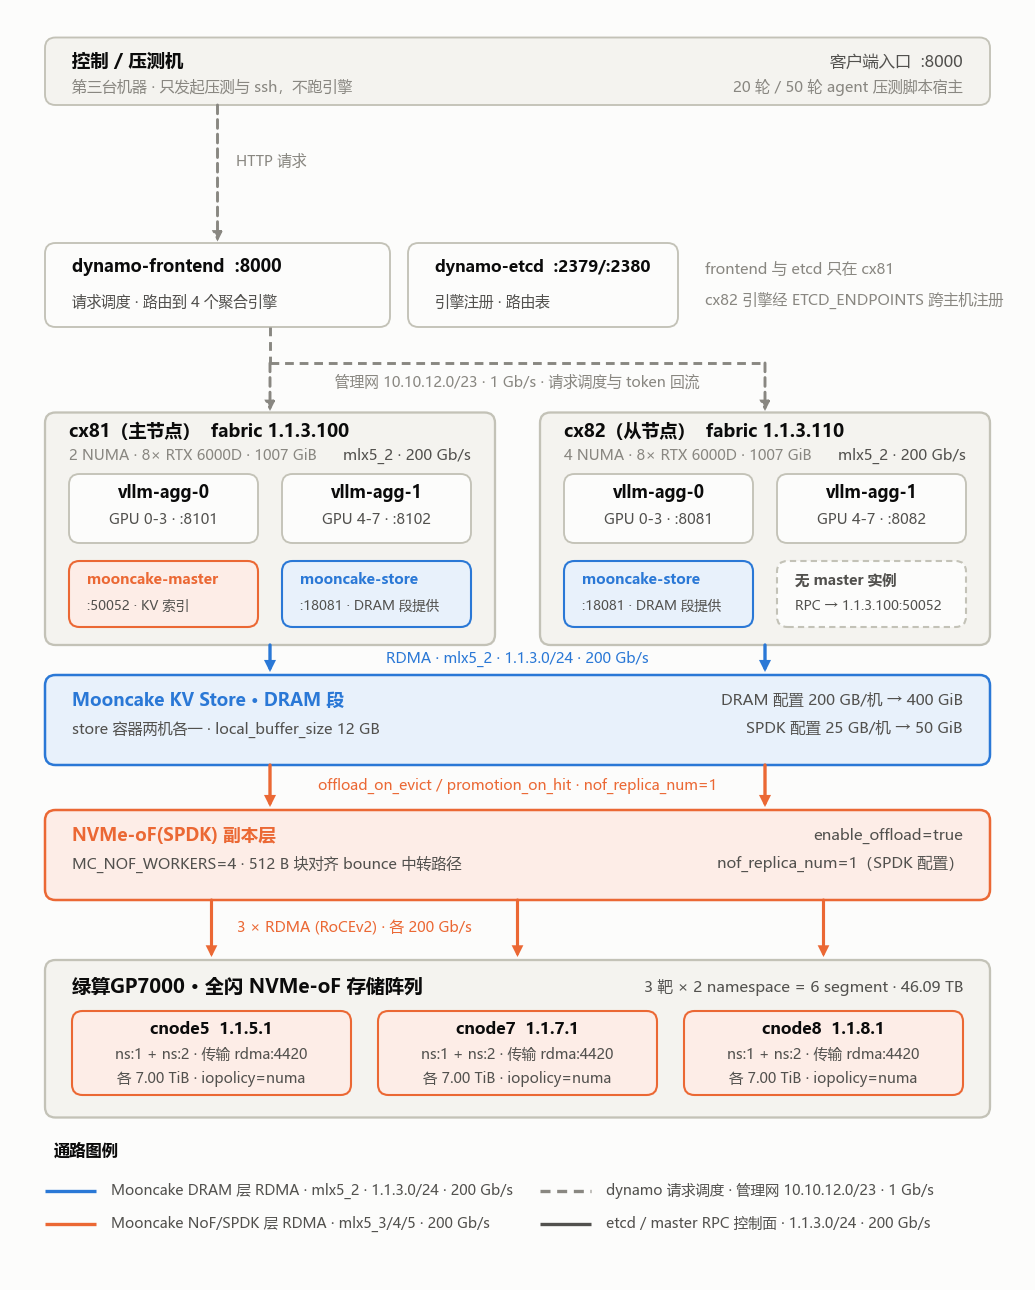
拓扑由三台机器构成:控制与压测机只发请求;cx81(master + frontend + etcd)与 cx82 各 8 张 RTX 6000D,一台 8 卡机器拆成 2 个 4 卡引擎,共 4 个 vLLM 聚合引擎;dynamo 调度,Mooncake 提供 DRAM 段与 NVMe-oF 副本层,KV 面共用一条 200 Gb/s RoCEv2 fabric。存储侧绿算 GP7000 以 SPDK 承担 NVMe Target,对上层呈现 46.09 TB 的 NoF 池。
两套配置只差两个位置:DRAM 配置把 KV 全部落在内存,每机 200 GB ⇒ 400 GiB,不开 NoF;SPDK 配置把 DRAM 段压到每机 25 GB ⇒ 50 GiB,46.09 TB 全闪作为不驱逐的副本层接在后面。
这不是“同样大小的内存再加一层盘”,而是内存砍到 1/8.用全闪把容量补回来——后面每一个“打平”都建立在这个前提上。
吞吐打平:
差异被解码时间稀释
f=1.0 的纯读路径,C=1/8/16/32/64 五档吞吐比为 1.000 / 1.014 / 0.981 / 0.985 / 0.980.全部落在噪声区间——这不是“接近”,是打平。
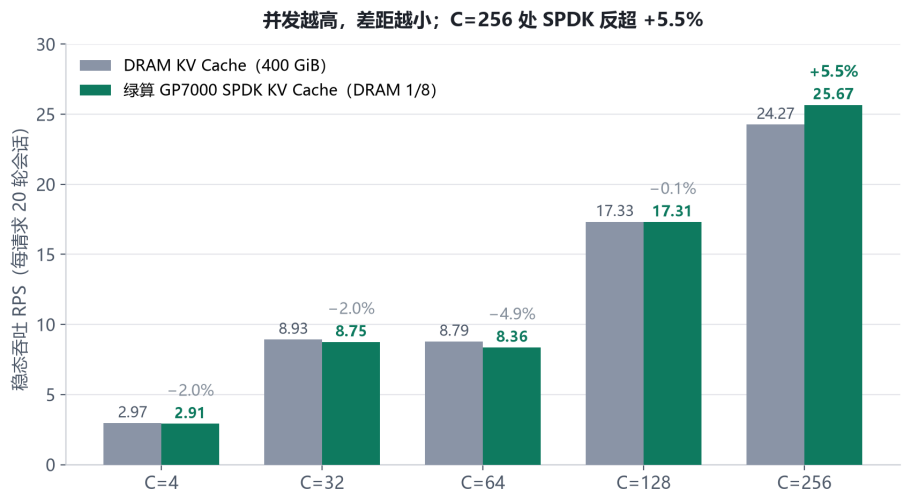
真实负载同样如此。20 轮 agent 会话(osl=128)14 个测试点 0 错误,稳态 RPS 差异 −0.1% ~ −4.9%。推到 C=256 结论反转:全闪 25.67 RPS,纯内存 24.27 RPS,反超 5.5%,两模式命中率逐位相同——饱和在引擎侧,不在存储侧。
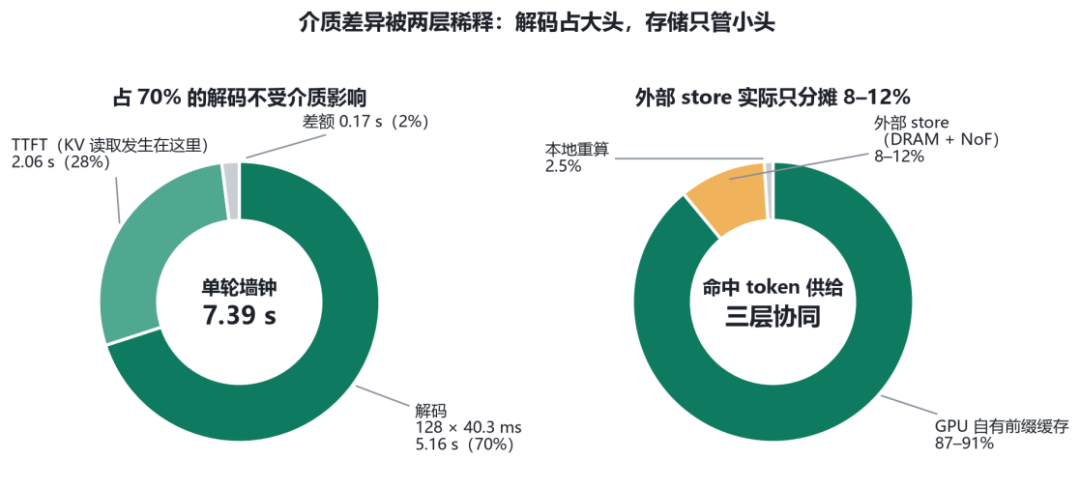
原因是一笔很干净的加法:C=128 时单轮墙钟 7.39 s = TTFT 2.06 s(28%,KV 读取就发生在这里) + 解码 5.16 s(70%)。每轮时间几乎全由“TTFT + 解码”构成,没有额外的“等存储”;KV 读取依附的 TTFT 只占四分之一强,介质差异被解码稀释掉了。
容量悬崖:
DRAM 的失效不可逆
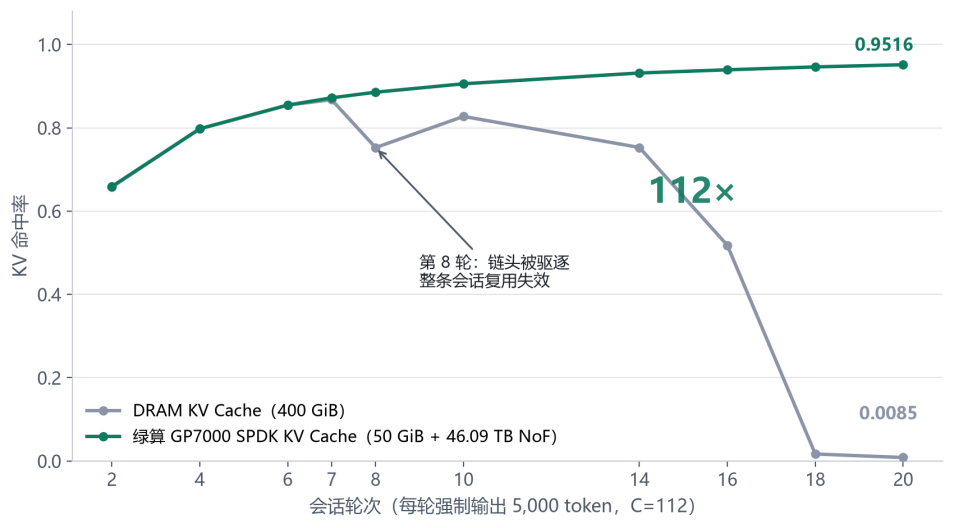
vLLM 的前缀缓存是链式块哈希——第 k 块的哈希包含第 k−1 块。LRU 驱逐的最旧块正好是链头,链头一掉,整条会话复用一起失效;叠加“驱逐 → 重算 → 重写 → 更多驱逐”的正反馈,实测单轮写入从 50 GB 飙到 1.051.8 GB,放大 20 倍。所以这是悬崖,不是缓降,而且不可逆。
长输出场景(osl=5000.20 轮,C=112):纯内存命中率 t16 为 0.5181 → t18 为 0.0169 → t19/t20 只剩 0.0085.TTFT p50 抬到 246.236 ms,单轮墙钟 727.3 s;全闪稳定在 0.9516.TTFT 16.852 ms,单轮 277.7 s。t20 这一点上,命中率差 112 倍、TTFT 差 14.6 倍、墙钟差 2.62 倍。
工作集超容是同一副面孔:471 GB 放进 429.5 GB 的池子(实测均衡仅 383.3 GB),t2 一轮纯内存 121.0 s、重算 272.8 万 token,全闪仅 11.4 s、2.4 万 token。50 轮超长会话则回答“能不能做”:全闪命中率从 0.6580 单调升到 0.9797.3.90 小时 0 错误;同等负载下纯内存在 t20 就耗尽,50 轮在算术上不可行。崩落甚至能提前算出:429.5 GB ÷(C × osl × 88.1 KB)= 8.6 轮,实测正好在 t8 崩。
三层协同:
97.5% 的命中率是谁在兜底
20 轮稳态下按 prompt token 拆命中来源:本地重算约 2.5%,GPU 自带前缀缓存 87.3%–91.5%,外部 store 读取 8.0%–11.4%。store 层从来没有被逼成瓶颈——GPU 那一层(4 引擎 × 3.471.060 token)吃掉绝大部分命中,外部存储只在容量边界处兜底,这才是吞吐能打平的机理。
全闪侧的证据更直接:DRAM 段只有 50 GiB,从 C=32 起锁死在 48.3 GB,工作集却要 156 GB,命中率仍是 0.9752——至少 2/3 的命中读由全闪供给。计数器同向:全闪模式 master_nof_allocated_bytes 随并发单调增长,纯内存模式全程 0 增量。
一个先让 8 倍的前提
报告把最不利条件写在明处:全闪侧 DRAM 只有 50 GiB,是纯内存(400 GiB)的 1/8.每一个“打平”都是先让了 8 倍之后取得的。有效性也不靠叙述——两模式 save_put 总 keys 差 +0.1%、load_get 差 +0.3%,累计错误 0;纯内存模式写了 1.49 TB 对象,NoF 增量 0.0 B。
落点,最后落在参数上
“落在哪一层”不只由硬件决定,也由几个参数决定,且都属于“不设就不工作”:
· PYTHONHASHSEED 必须为 0。不设则跨进程 block hash 不一致,静默 miss,永远读不到。
· prefix-cache-retention-interval 必须设 None。不设时 lookup 1.127 次只对应 save_put 71 次(差 23 倍),命中恒为 0.
· local_hostname 必须填 fabric 字面 IP。写成管理 IP 时握手照样成功,搬数据静默返回空,tier 恒为 0 B。
· SPDK 数据面硬校验 512 B 对齐,而 DSV4 的 KV 对象恒为 1.002.240 B ≡ 256 (mod 512),为此在 Mooncake 数据面加了块对齐 bounce buffer 路径。
这些细节不上台面,但决定成败。黄飞打算在演讲里把它们讲出来——一份能被别人复现的报告,比一个漂亮的结论更有价值。
黄飞表示,KV Cache 的分层落点,本质上是把“不算最快、但足够大”的介质放到一个可以被信任的位置上。全闪不会替代内存,但它可以把“容量”这一维从系统里拿掉——让多轮长会话从“命中率崩落”变成“命中率单调上升”。同一次实测里,这个差别是 107 倍容量、112 倍命中率、2.62 倍墙钟。“我们更愿意把这份报告看成一份可复现的工程记录:拓扑、配置、判据、口径都在里面,任何人可以照着跑一遍。”