ODCC算网底座 | 【网存算协同】存储入参:参数面与存储融合,释放算网新势能
随着大模型推理迈入 Agent 时代,超长上下文、超高 KV Cache 命中率以及短追加模式等典型负载特征,正推动以存强算成为性能优化的核心范式。KV Cache 的规模化复用,彻底颠覆了传统以算力为主导的推理架构,系统瓶颈逐步从算力受限,转向网络传输带宽不足、网存算协同低效。一场围绕 KV Cache 的基础设施变革,正在数据中心网络内部加速落地。为破解传统样本面网络带宽不足的瓶颈,行业正全面将前缀 KV Cache 流量从样本面迁移至高带宽参数面,掀起以 KV Cache 为一等公民的网络融合架构革新。与此同时,CacheBlend、FusionRAG 等新型缓存融合技术持续突破传统严格前缀匹配的约束,进一步拓宽 RAG 场景下 KV Cache 的复用边界。存储入参的网络架构演进与软硬协同缓存复用,共同构成大模型推理基础设施全面升级的核心方向。
一、存储入参出现背景
当大模型推理的系统瓶颈从算力不足悄然转向带宽受限,一场围绕 KV Cache 存储与传输的基础设施革命正在数据中心深处上演。从 HBM 到分布式存储,从样本面到参数面,支撑大模型推理的高速通道正在被重塑。
以存强算:从前沿技术探索走向行业标准配置
基于前缀缓存复用的以存强算技术,在短短两年多时间里,从学术前沿方案快速落地迭代,现已成为 DeepSeek、月之暗面、Anthropic、OpenAI 等全球头部大模型厂商的标准配置。该技术核心逻辑简洁高效:将历史请求生成的 KV Cache 持久化缓存,新请求命中相同前缀时,系统直接加载对应 KV Cache,规避 Prefill 阶段重复计算。该机制既能显著压缩 TTFT,也可大幅提升系统整体吞吐量。但随着上下文窗口持续扩展、并发请求规模快速增长、KV Cache 生命周期不断拉长,KV Cache 存储规模呈指数级膨胀。如何做到存得下、存得起、存得住,成为所有推理基础设施团队必须直面的现实问题。
存储介质四级跃迁:从单机私有架构迈向集群全局共享
KV Cache 存储介质,正经历由单机高性能形态向集群全局共享形态的深度演进。HBM 显存作为算力卡贴身存储,凭借超高带宽、超低时延筑牢推理实时性底座,但成本高昂、容量有限,无法独立承载海量 KV Cache 数据。为突破该瓶颈,服务器 CPU 内存以更可控的成本承接部分温热缓存数据,却仍受单机物理内存上限约束。在此基础上,服务器本地 SSD 提供大容量低成本持久化空间,支撑 KV Cache 长期留存,但其性能受总线带宽制约,节点故障或集群扩缩容时还存在缓存丢失风险。为彻底打破单机存储孤岛,基于 RDMA 技术的高性能分布式方案应运而生,成为 KV Cache 存储架构演进的重要方向。将 KV Cache 下沉至分布式存储节点,实现三大核心跨越:一是缓存全局池化共享,破除节点物理隔离,前缀缓存命中率显著提升;二是存算分离,推理节点与存储节点解耦,支持集群弹性扩缩容且缓存数据不丢失;三是极致降本,依托分布式介质池替代昂贵单机硬件,有效压低推理服务综合成本。
Agent 时代推理任务新特性将网络推上主战场
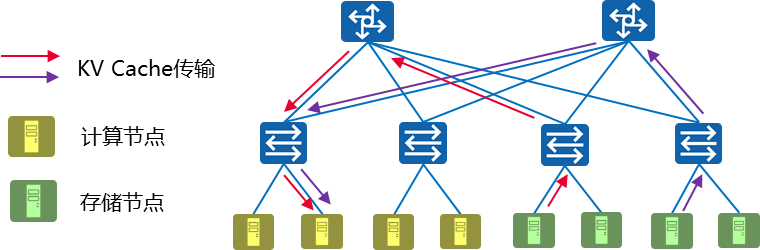
大模型从单轮对话工具演进为多轮智能体系统后,负载呈现超长上下文、超高 KV Cache 命中率(通常≥95%)、短追加模式等特征。在这类场景下,一个根本性转变逐步显现:通信耗时远超计算耗时,计算节点频繁空转等待 KV Cache 数据,系统瓶颈从算力侧根本性转移至网络通信侧。当瓶颈从 “算不动” 变为 “传不快”,破局路径清晰明确:行业加速采用高带宽参数面网络替代传统样本面网络承载 KV Cache 传输,也就是存储入参。
二、存储入参业界技术实践
DeepSeek 联合北大清华提出 DualPath 架构:双路径破解样本面网络带宽瓶颈
当前大模型推理普遍采用 PD 分离架构,样本面网络带宽失衡是制约系统性能的核心痛点。在以存强算 KV Cache 复用场景的常规运行机制下,Prefill 实例需要频繁从外部存储节点加载海量历史 KV Cache,极易打满配套存储网卡带宽,引发数据加载阻塞、推理卡顿等问题;与之对照,负责自回归生成的 Decode 实例,配套存储网卡长期处于低负载闲置状态。这种单点带宽瓶颈严重拖累系统整体吞吐量。 为破解该难题,DeepSeek 联合北京大学、清华大学研究团队推出全新推理系统架构 DualPath,创新设计双路径 KV Cache 加载机制。传统架构仅具备 “存储→Prefill” 单一传输链路,DualPath 架构新增 “存储→Decode” 专属传输路径,支持 KV Cache 先利用 Decode 实例闲置存储网卡完成加载,再经由参数面网络转发至 Prefill 实例,聚合全集群节点存储带宽资源。

在此基础上,DualPath 架构完成机间、机内双层网络链路全维度优化,搭建完备的 QoS 调度体系。针对机间参数面网络,依托原生 QoS 能力实现精细化流量隔离,采用加权轮询调度,为高优先级集合通信流量预留约 99% 总带宽,剩余带宽供给低优先级 KV Cache 传输流量,避免流量饿死。针对机内 PCIe 链路,将计算网卡作为全域 PCIe 流量的中央 QoS 调度单元,优先保障集合通信流量传输,复用链路空闲带宽承载 KV Cache 数据传输,全方位提升大模型推理系统稳定性与吞吐能力。
英伟达 ODCC 报告:高带宽与 GPUDirect Storage 成为推理性能提升的关键
正如 DualPath 研究结论所示,面向 DeepSeek-27B、Qwen2.5-32B 等模型,仅依靠样本面双路径 KV Cache 加载机制,依然难以触达推理性能理论上限,必须引入带宽资源更充裕的参数面承载 KV Cache 流量。在 2026 年 ODCC 春季全会上,英伟达发布《面向大模型推理的 KV Cache 卸载架构评估报告》,以实测数据印证 DualPath 研究结论:不启用 GPUDirect Storage(GDS)时,单台 GPU 服务器存储带宽从 800Gbps 翻倍至 1600Gbps,吞吐量最高提升 47%;开启 GDS 之后,吞吐性能最高提升 522%。在以存强算 KV Cache 复用场景中,高带宽网络叠加 GDS 硬件加速,已经成为释放推理极致性能的核心抓手。
华为 Atlas A3 集群实测:实验结果突显高带宽参数面核心价值
华为基于自研 Atlas A3 昇腾算力卡集群,围绕不同存储带宽配置下的以存强算 KV Cache 复用场景开展对照测试。测试结果表明,网络架构小幅调整即可收获可观性能收益:仅将每卡 50Gbps 样本面带宽升级替换为每卡 400Gbps 参数面带宽,系统推理吞吐性能实现 52%~486% 的跨越式提升。该结果和业界前沿理论推演高度契合,同时向行业传递明确信号:在大模型推理架构后续演进中,搭建独立、高带宽的 KV Cache 参数面网络,是突破推理性能天花板的关键。
三、存储入参未来演进
RAG 检索增强生成技术,通过在生成回答前检索外部知识库,有效缓解大模型知识滞后与幻觉问题。但传统以存强算 KV Cache 复用依赖前缀完全匹配,在 RAG 场景下常常失效。一方面,用户查询引导前缀各不相同;另一方面,RAG 系统会对文档块动态检索、重排序,相同内容在上下文的位置持续变动。即便输入文档集合一致,顺序差异也会导致缓存无法命中。如果选择对每个文档块单独缓存来提升复用率,又会损害生成答案质量 —— 独立缓存割裂全局上下文,文档块之间缺少交叉注意力,模型难以形成连贯语义理解与逻辑推理。
芝加哥大学提出 CacheBlend 机制:缓存知识自由融合,解除前缀匹配约束
CacheBlend 是面向 RAG 场景的高效 KV Cache 融合推理方案,打破以存强算 KV Cache 复用必须严格前缀匹配的固有限制,支持离线预计算 KV Cache 按任意位置、任意分块跨场景复用。其核心创新为选择性重计算:CacheBlend 不会无差别复用全部预计算 KV Cache,而是精准识别并对少量 Token 对应的 KV Cache 重新计算。该机制仅付出极低额外计算开销,就能将多段独立分块缓存融合成语义连贯、注意力计算合法的完整上下文,修正交叉注意力偏差。同时,CacheBlend 把 KV Cache 加载与重计算流程编排为流水线,掩盖计算与 I/O 开销。系统可将大容量 KV Cache 卸载至低成本、大容量外置存储节点,且不增加推理时延。实测数据显示,对比全量重计算基线方案,CacheBlend 可将 TTFT 降低 2.23.3 倍,吞吐量提升 2.85 倍,生成质量基本无损失。
清华大学提出 FusionRAG 机制:离线预嵌入叠加在线重计算,兼顾速度与质量
CacheBlend 在中小模型场景可维持较高生成精度,但模型规模扩大后,生成质量会出现明显衰减。针对该痛点,清华大学研究团队提出 FusionRAG 框架,联合优化 RAG 推理的预处理、重处理两个阶段,实现性能与质量的更优权衡。离线预处理阶段,FusionRAG 采用相似度引导交叉注意力预构建机制,依托检索文本块的语义相似度、召回概率相关性,离线将关联文档块上下文信息预嵌入每个分块的 KV Cache,从源头弥补在线推理时跨块注意力交互缺失问题。在线重处理阶段,引入查询引导选择策略,根据用户查询真实注意力分布锁定关键 Token,仅对少量 Token 重算 KV Cache,在最大程度保留生成质量的前提下压缩在线计算开销。实验结果表明,在重算 Token 占比低于 15% 的条件下,相比全量重计算基线,归一化 F1 分数最高提升 70%,TTFT 降低 2.669.39 倍。
四、存储入参核心技术挑战
参数面与前缀 KV Cache 存储网络深度融合,在充分释放算网新势能的同时,也对端网协同机制、拥塞控制算法、优先级调度策略等核心方向提出更高要求。
挑战一:前缀 KV Cache 必须全部收齐方可启动计算
大模型 Decoder 架构固有特性决定:每一个 Token 的计算都依赖前文所有 Token 对应的 KV Cache 信息。即便引入分层加载、计算优化,当前请求也需要等待全部前缀 KV Cache 完整加载至算力卡显存后,才能启动后续计算流程。该机制极易形成木桶效应:算力卡计算进度由最晚到达的 KV Cache 数据块决定。想要消除等待时延,系统需要精细化网存算协同机制,对齐来自不同存储节点、同一存储节点内不同 KV Cache 分片的加载时序。核心目标是让全部依赖数据尽可能同步完成加载,拉高算力卡计算利用率,消除计算空闲气泡。
挑战二:前缀 KV Cache 流量天然存在多打一现象
分布式 KV Cache 存储架构中,历史 KV Cache 数据一般通过一致性哈希分散存储在多个存储节点。处理请求时,需要从多存储节点并发拉取离散 KV Cache 数据,汇总加载至目标算力卡显存。该模式天然在目标算力卡接入网卡或者上联交换机端口形成多对一流量。短时间内多路数据流汇聚,极易诱发网络微突发,造成缓冲区溢出、丢包、尾时延飙升。想要解决 Incast 难题,需要定制化拥塞控制算法以及配套优化手段平滑流量尖峰,保障 KV Cache 加载高效稳定。
挑战三:网络融合后多类流量相互干扰
前缀 KV Cache 流量从样本面迁移至参数面后,参数面承载流量类型持续增多。新增流量会和原有训推集合通信流量、PD 分离 KV Cache 流量争抢资源,如何区分各类流量优先级、设计配套调度策略成为亟待解决的核心问题。与此同时,该变化可能导致数据中心网络可用无损队列数量少于流量类型总数,打破一类流量独占一个专属队列的理想假设,给交换机队列调度带来全新挑战。
五、总结
存储入参是突破当前大模型推理性能天花板的关键技术路径。依托分布式共享存储架构与高带宽参数面网络,能够有效解决传统单机存储容量受限、样本面带宽瓶颈、节点故障缓存失效等核心问题。现阶段 DeepSeek 双路径加载架构、英伟达 GDS 硬件加速、华为 Atlas A3 高带宽集群等业界实践,充分验证了存储入参体系可观的性能增益。但现有技术体系仍存在短板:前缀 KV Cache 加载的木桶效应、分布式拉取带来的 Incast 拥塞、多流量共享队列引发的资源冲突等问题尚未完全攻克。面向未来,持续完善网存算协同机制、研发定制化网络拥塞控制算法、搭建精细化多流量 QoS 调度体系,将是释放参数面网络潜力、实现大模型推理极致降本增效的核心迭代方向。
“算网底座:
从网络架构到算网协同的系统化演进”系列
联系人:郑老师:18600606469 邮箱:zhengchangkui@caict.ac.cn
ODCC秘书处联系人
刘老师:13488889649 邮箱:liupengyun@caict.ac.cn