ASC分享 | 华为刘俊:AI存储层级重构,实现PB级KV缓存与内存替代,加速推理规模化落地
2026年10月21日,2026先进存力大会在上海举行。华为数据存储首席研究专家刘俊发表题为《从“算力为中心”到“数据为中心”:AI存储层级重构的思考与实践》的主题演讲。他表示,随着大模型参数规模持续膨胀、MoE专家数量增加、上下文序列不断加长以及多模态AI应用加速普及,传统存储架构已难以满足AI推理场景对高带宽、低时延和高耐久的要求。为此,华为通过自研存算网三合一芯片、GPU直通技术及高耐久介质创新,重构AI存储层级,给出在AI workload下以自研ASU(AI存储语义模组)替代DDR内存池的可行技术路径。
刘俊
华为数据存储首席研究专家
AI技术高速发展,存储正从“算力驱动”走向“数据驱动”,并面临多重挑战
1、Prefill阶段KV Cache存在I/O路径DDR带宽瓶颈突出、网络冲突明显、介质寿命不足等问题;Decode卸载场景下HBM容量墙问题突出,吞吐受限。
2、传统内存池在GPU为主要计算主体的AI时代已不适用。一是访问主体及访问范式发生变化:CPU核数有限且对时延敏感,访问内存时需等待数据返回;GPU以带宽驱动为主,核数多、并发度高,对时延相对不敏感,可容忍更大延迟。二是访问范式发生变化:AI场景多层网络装载数据可实现较多访问掩盖,支持边计算边装载。这些变化导致了传统以CPU为中心的类CXL内存池设计没有充分利用新型工作负载的访问特征,在DDR介质成本较高的背景下存在明显问题。
3、AI workload 以月级迭代,基础设施却以年为单位更新,二者存在节奏错配。基础设施需要超前建设,模型开发者可以充分利用基础设施的能力实现双向奔赴。
AI存储层级重构的思考与实践
刘俊表示,应对上述挑战,需要围绕AI推理场景重构存储层级,关键技术包括:
1、Prefill场景:通过原生存算网三合一芯片,去除DDR带宽瓶颈,并支持原生KV语义,实现IO全硬化;通过XPU/CPU双栈直通,减少网络跳数与网络冲突,实现算力直通访问;通过场景化介质寿命优化,智能管控KV数据生命周期,提升介质耐久性。
2、Decode场景:充分利用GPU访问特征,通过多流算子掩盖,提供充足的I/O加载窗口,并实现多核高并发I/O下发;通过ASU提供高IOPS与稳定低时延,达成相较内存池更具性价比的收益。
实测结果显示:在GLM-5.2模型、128K输入序列、华为昇腾950DT芯片、PD分离场景下,采用ASU方案Decode卸载性能相较HBM和DDR方案有明显提升。相较仅HBM方案,最大Batch Size提升357%,TPS提升57%;相较仅DDR方案,最大Batch Size提升167%,TPS提升40%。
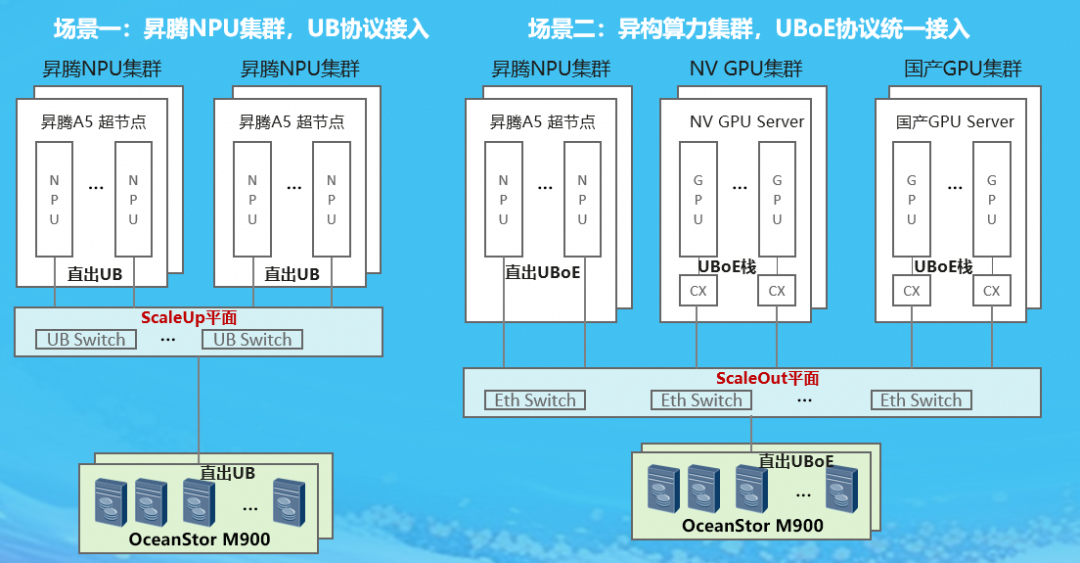
ASU方案还具备异构网络接入优势,即一套存储可同时支持昇腾UB互联协议接入以及第三方GPU的Scale-Out以太协议接入;在同等成本下,相较业界RoCE方案性能提升50%。
随着AI基础设施从“算力为中心”逐步走向“数据为中心”,存储层级正围绕AI负载与GPU/NPU的访问特征发生重构。DDR内存池成本高、扩展性受限,难以支撑长上下文与高并发推理中持续膨胀的KV Cache,而ASU则提供了一条更具性价比的路径。
AI存储重构的核心是重新设计I/O路径、存储层级、介质控制与异构生态适配,目标是用一套存储设备同时覆盖L3.5层PB级共享KV缓存与L2.5层DRAM卸载需求,对Prefill与Decode形成端到端加速。华为ASU为核心承载这一层级重构,在不堆叠昂贵DRAM的前提下,为长上下文推理提供可持续扩展的记忆底座。