ODCC成果|《Scale-up在网计算接口技术要求1.0》:打通在网计算在XPU侧的实施卡点

一、在网计算的意义和实施难点
随着生成式大模型、多模态人工智能业务持续迭代,模型参数量从百亿级向万亿级快速扩张,在千亿、万亿参数模型迭代过程中,每轮反向传播均需执行海量梯度All-Reduce、参数广播、分片聚合等集合通信操作,通信开销已成为制约集群训练吞吐、硬件利用率提升的核心瓶颈。在此背景下,专用Scale-up交换芯片成为超节点互联的重要枢纽,新一代交换芯片深度融合在网计算硬件架构,将梯度规约、全局广播等集合通信计算从XPU卸载至交换芯片硬件执行,从根源缓解Scale-up互联的通信瓶颈。
算力加速器与交换芯片二者硬件链路、计算语义深度关联,集合通信、在网规约等功能高度依赖端侧算力单元与网侧交换芯片协同联动,因此很有必要制定XPU到互联模块的统一在网计算接口标准。各类国产Scale-up互联链路搭配自研交换多播原语,不同厂商硬件指令语义、报文事务内容、应答同步机制不兼容,导致跨厂商硬件组合存在适配壁垒。构建统一的在网计算接口标准,可规范硬件多播、规约、批量拷贝等核心原语定义,统一事务请求、应答逻辑,方便不同厂商XPU与交换芯片互联互通,降低集群异构部署适配开销,是释放在网计算通用加速价值的重要基础。
二、在网计算的架构
集合通信操作通过INC-Switch来执行,整个执行过程需要协同XPU软件、通信库软件、Scale-up 互联模块(Link IP)、INC-Switch、INC管理模块等多种组件。
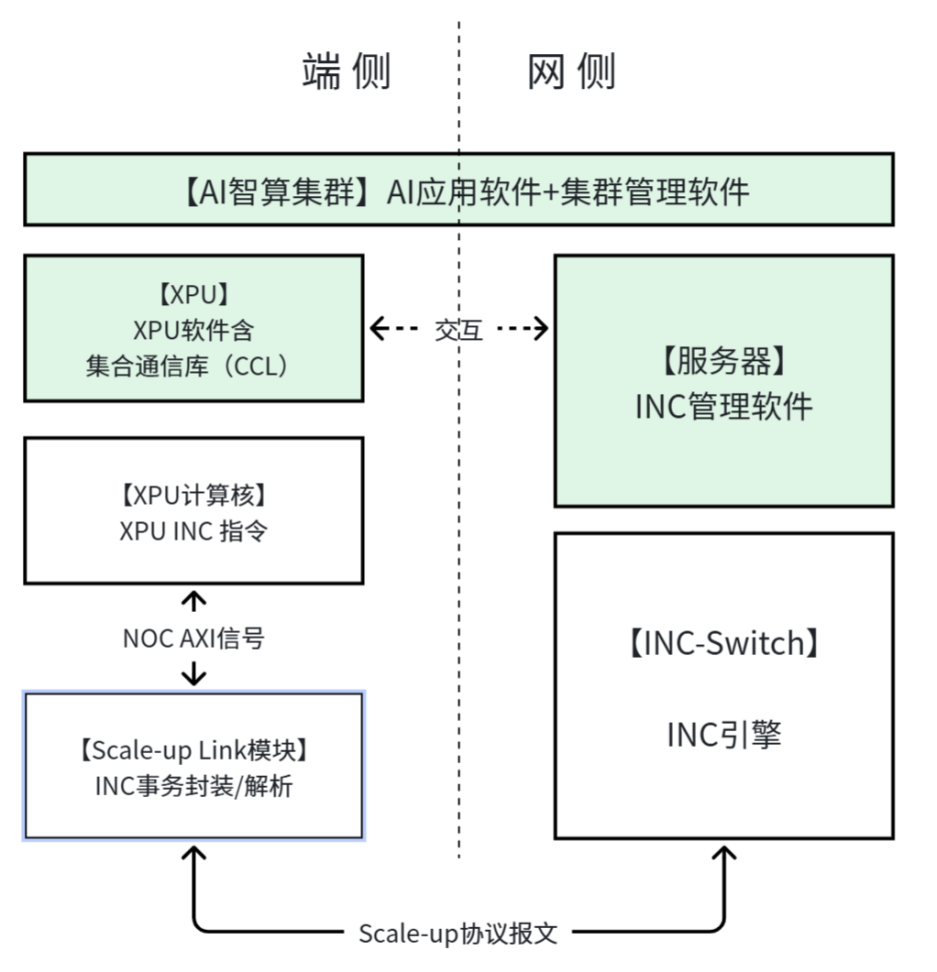
图 1.在网计算架构框图
在网计算相关的集合通信操作主要的执行步骤是:
步骤一:服务器端INC管理软件创建集合通信组;
步骤二:XPU向INC管理软件申请加入通信组,并注册对称地址区;
步骤三:XPU软件发起集合通信操作,调用在网计算相关指令或下传信令;
步骤四:在网计算指令通过XPU编译器翻译后在XPU内部NOC上通过信号线携带在网计算信息;或进一步转换成Chiplet接口信号;
步骤五:XPU的Scale-up Link模块接收来自NOC(或Chiplet接口)总线的INC信令和INC指令,进行必要的事务处理,按照底层Scale-up协议封装成包含INC信息的报文,与INC-Switch通信;
步骤六:INC-Switch解析各Scale-up Link模块的INC报文进行必要的规约计算操作或多播操作,数据回送相关Scale-up Link模块;
步骤七:Scale-up Link模块接收INC-Switch的回复数据或应答信息,进行相应处理后通过NOC(或Chiplet接口)回送XPU。
三、在网计算原语与操作拆解
把集合通信中可能调用的INC-Switch参与的关键多播和在网计算操作归纳为一系列基本的“在网计算原语”,并根据驱动方式分为“直驱型在网计算原语”和“数据块型在网计算原语”两类。
直驱型在网计算原语由XPU核通过指令方式直接发起,并通过指令的Request—Response动作即时(同步)完成,属于同步内存语义。包括:incsw.ld_reduce和incsw.st_multicast。
数据块型在网计算原语可由CPU或者XPU核通过向Link IP写入信令的方式发起,异步执行,CPU或XPU核通过查询相应的完成标志来确认执行完成,属于异步内存语义。包括incsw.blk_reduce、incsw.blk_allreduce和incsw.blk_multicast。
确定在网计算原语之后,我们尝试将八种集合通信操作的执行过程进行步骤分解,其中必要处调用在网计算原语。小数据量的集合通信一般调用“直驱型在网计算原语”,大数据量的集合通信则可以选择调用“数据块型在网计算原语”或者循环多次调用“直驱型在网计算原语”。
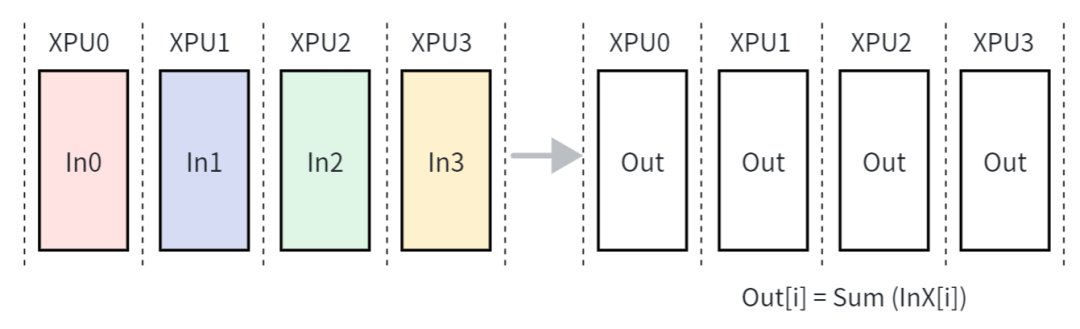
图 2.AllReduce操作示意
以AllReduce为例,
方式一:(直驱型)
步骤1:任一XPU调用在网计算原语incsw.ld_reduce,通过INC-Switch执行reduce操作并获得结果数据;
步骤2:任一XPU调用在网计算原语incsw.st_multicast,将上述reduce结果数据多播到所有组内XPU。
方式二:(数据块型)
步骤:任一XPU直接调用在网计算原语 incsw.blk_allreduce,一步完成。
四、在网计算接口
在网计算原语由XPU核发起,通过片内NOC总线(或再经Chiplet接口)下发至Scale-up Link模块,为了实现不同的XPU厂商与不同Scale-up 互联IP厂商之间的互联互通,有必要推荐或定义统一的在网计算接口。直驱型在网计算原语经由NOC总线信号下发,数据块型在网计算原语则经由信令报文数据下发。
“直驱型在网计算原语”包含incsw.ld_reduce和incsw.st_multicast,对应两条“在网计算指令” ld_reduce和st_multicast,由XPU核直接发起,通过NOC总线下发,XPU厂商的NOC总线多采用AXI信号或自扩展的AXI信号。
“数据块在网计算原语”包含incsw.blk_reduce、incsw.blk_allreduce和incsw.blk_multicast,一般以控制信令形式通过驱动程序或XPU核写入到scale-up Link模块。文档中给出了建议的信令格式。“数据块型的在网计算信令”既可以由XPU加速器核函数发起,也可以由CPU程序发起。
五、结语
Scale-up在网计算接口技术要求在ODCC的发布,标志着Scale-up交换芯片的在网计算实现不只停留在网侧的设计和探讨,而是进一步延展到XPU内部端侧的开放通用实现,在网计算是典型的端网协作过程,也是软硬件深度协同的操作。封闭紧耦合走向开放解构已经成为产业共识,通过标准牵引生态,产业各方力量将共同构建可持续发展AI基础设施的算力底座。
项目经理:
刘学
技术联系:
欧阳捷 ouyangjie@twcl.ai
ODCC边缘计算工作组对接人:
周老师 zhouman@caict.ac.cn