单柜迈进兆瓦级:AI服务器的“供电+散热+互连”攻坚战 | 2026ODX回顾
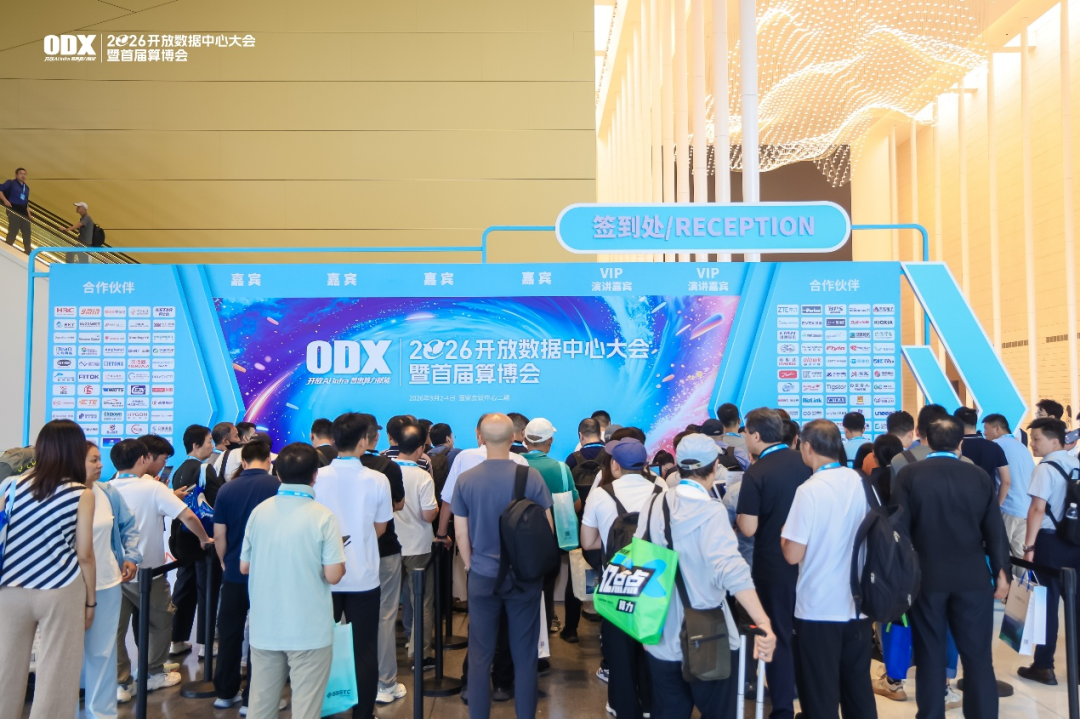
9月2日,2026开放数据中心大会暨首届算博会(ODX)计算分论坛举行。来自阿里云、百度、中国电信、中国移动、锐捷网络、英维克、安费诺、江波龙、永铭电子等企业的技术专家,围绕计算发展核心命题展开研讨。与会者的普遍共识是:当单芯片功耗突破2000W、单机柜功率迈向兆瓦级,AI服务器竞争已从单芯片性能转向"互联+供电+散热+运维"的系统级工程能力,而开放标准与模块化解耦,是应对算力芯片快速迭代、避免供应锁定的共同答案。ODCC服务器工作组副组长郭锐主持会议。
一、超节点整机架构与开放标准:
把"整机柜"变成可组装、可演进的开放系统
"开放不是态度,是接口。"阿里云钟杨帆以《超节点下一代硬件工程技术与标准》为题介绍磐久AI Infra2.0超节点的工程实践时,把开放落在接口层面:协议层支持Alink协议互连,节点层多源兼容多款GPU与交换芯片,并在整机、冷板、高速连接器、集中供电等领域推进国产生态,主张"生态不是名单,是验证流水线"。磐久AI Infra2.0实现单柜128卡、64卡Scale-Up互连:单柜350kW+集中供电达到"6个9"可靠性,PSU内置超大电容应对EDPP;仿生叶脉管路自适应流量分配与三级漏液检测;正交架构与模组化设计实现互联模组分钟级维护。展望下一代,他提出224G SerDes铜互连边界探索、兆瓦级机柜与800VDC架构、100%热捕获无风扇设计三大方向。
缓存命中率越高、互连带宽需求越大,CPU侧工具处理最多占总延迟的90.6%——这是天翼云白秀杨从Agentic AI应用反推出的两大硬件瓶颈。天翼云紫金架构超节点据此设计兼容多芯的统一开放架构、整机柜模块化解耦、单柜140kW+直流供电与单GPU 1.6kW+冷板液冷;其HPKV缓存服务将KV Cache下沉扩展至CPU内存与高性能存储,长文档多轮对话TTFT降低80%+,64并发下吞吐提升2倍以上。
"让硬件像积木一样可拆、可换、可扩。"百度盛永如此概括《Agent时代的计算节点模块化设计》:主板模组支持多平台与国产化、GPU UBB模组兼容多厂商方案实现跨代平滑演进;21寸标准1SU机箱与前窗IO最大化设计;Barclip与54V Busbar插接取电、集中供电释放算力密度;冷板液冷支持单GPU 1200W(CPU温度降低25℃、GPU降低20℃);RMC+BMC两级带外管理与漏液实时监控。他总结道:"算力百花齐放,模块标准先行。"
以Scale-out的开放思路,解决Scale-up的封闭难题——中国移动徐小虎发布的《开放解构超节点系统架构技术规范1.0》给出了传统超节点"协议私有封闭、硬件紧耦合、规模扩展受限"痛点的系统性答案。开放解构超节点以以太网为统一底座(支持已提交IETF草案的FARE全自适应路由以太网),计算节点风冷/液冷/交换节点多形态灵活组合;多厂商AEC实测post_FEC_BER全部为0。
二、800V HVDC供电演进:
从"物理必然"走向规模商用元年
50V母线电流超20kA,已无工程可实施性——这是锐捷网络李武(论证800V高压直流"物理必然性"的出发点:单机柜GPU满载已突破1MW,电压提升一个数量级后电流降至1/15以下、端到端能效提升33年工程落地主线,"800V直供进板"预计2028年商用。工程制高点上,锐捷展示了峰值效率97.5%的液冷PDB,并提出垂直供电是芯片侧终局——净效率可从72%提升至87%。
"一次接触失效就是一次整机断电。"安费诺Roy Wu从连接器视角补齐了800V链路的可靠性命题:一条660kW机柜电源链路包含上百个大电流接触点,接触电阻微欧级漂移、多PSU并联不均流、热插拔电弧烧蚀都是典型失效模式,而电源连接器失效没有"降级运行"的缓冲。他以量化测算收尾:互连与供电问题若使万卡集群可用性从99.5%降至99.0%,全年空转损失约等于50张加速卡,足以覆盖整个集群高品质互连方案的全部器件价差。
"算力越猛,电源越难;越难,越需要毫秒级缓冲+秒级后备。"永铭电子张烨烽如此概括超级电容在服务器备用电源中的角色定位。超级电容以低内阻高倍率特性在四个保护层级落地:PCS母线级削峰、BBU服务器备电实现秒级有序下电、RAID卡掉电接管保护写缓存、SSD PLP最后写入保护。他判断超级电容正从"可选器件"变成"系统能力",在四大场景中由"选配"走向"标配"。
三、液冷散热:
从"加分项"到"必选底座",可靠性成为第一命题
"当算力跨越兆瓦级门槛,液冷不再是加分项,而是必选项。"英维克黄斯浩在《"三全液冷"协同整机柜交付》开篇即给出这一判断:单机柜功率从30kW向300kW+发展已远超风冷极限,国外走单柜计算堆叠路线、国内走多机柜工程化路线,最终都指向整机柜液冷。英维克的"三全"方案覆盖三个维度:全链条——芯片级射流冷板应对200W/cm²+局部热流密度、节点级MQD小尺寸快接、机柜级QD50大流量自锁快接支撑500kW级机柜,机柜、CDU、Manifold、漏液检测一体化实现"单柜即液冷系统";全场景——构建器件级、出厂级、数据中心级三级测试验证闭环,推出全球首款集成化服务器测试产线;全生命周期——从冷板定制设计到定期工质检测的全程保障。
四、高速互连:
铜光共生,224G量产与448G攻坚并行
"光进铜退"的答案是铜光共生——这是安费诺Roy Wu对互连路线之争的回应:片内/封装内用CPC/CPO、板间用高速铜缆、跨区域用光模块,没有一种技术通吃所有场景。他观察到中国超节点的三条柜内互连路线:GPU+CPU一体化托盘、GPU/CPU分离+Cable Backplane、分离正交/近芯片飞线,并判断三条路线长期并存;112G/通道已规模量产,224G在中国进入开发导入期,正是方案定型的关键期。Cable Tray的门槛在五千对差分对的量产一致性与浮动容差的系统工程能力;面向448G,实测链路"有机会跑通"但裕量以dB计,需以高阶调制换信道预算。2026年是NPO走向标准与样机的关键一年,"接口形态一旦写入标准,将决定未来5年的器件格局"。
五、存储可观测性:
eSSD从"黑盒"变"白盒",数据驱动TCO优化
从"知道有问题"到"知道为什么有问题、下一步做什么"——江波龙曹匡文如此定义eSSD增强遥测相对于SMART的能力跃迁。他指出AI时代eSSD采购成本约3倍上升,消除存储侧瓶颈可减少GPU空转,而静默数据损坏、性能突降等风险直接威胁训练成果;相比SMART的"低频汇总快照",增强Telemetry实现"高频事件触发+细粒度指标+盘内原因链":训练场景瓶颈定位从小时级缩短到分钟级并保护Checkpoint;推理场景调度系统动态避开热点盘、稳定尾延迟;寿命管理按单盘真实磨损差异化换盘,年度备件成本存在约30%降低空间。他强调"能力随盘交付"、无需新增盘侧工具,并可与客户联合定义采集策略与AI调度平台联动。江波龙SPU存储处理单元还实现了存内无损压缩2:1、单盘最大容量128TB。
六、趋势展望:
AI服务器进入"系统工程+开放标准"双轮驱动时代
综合各演讲者的判断,AI算力底座各子系统的发展路线已高度清晰:
供电——800V三步走,焦点转向系统级协同。800V规模商用、12V/6V中间母线分阶段演进、VPD/IVR终末级重构三步走;产业竞争焦点正从电源架构本身转向"大电流连接可靠性+EDPp动态治理+秒级备电窗口"的系统级协同,标准互认、宽禁带器件与高压连接生态将成为2~3年内的决胜变量。
散热——冷板全液冷与100%热捕获成为标配方向。随单芯片功耗迈向2000W+,芯片、内存、网卡、硬盘、电源热源90%+液冷覆盖将成为标配;液冷竞争的差异化正从部件性能转向"全链条工程+全场景测试+全生命周期服务"的系统可靠性。
互连——铜守短距高密、光向板内推进。224G铜互连与NPO并行量产是2026—2027年主旋律,448G需连接器、调制、封装协同攻坚;标准竞争的窗口期正是器件格局的定义期。
存储——"盘内可观测"将从增值选项变为基础能力。Telemetry与平台调度、故障预测模型的深度联动,将推动存储运维从"被动告警"走向数据驱动的主动闭环。
从50V到800V、从风冷到全液冷、从SMART到Telemetry、从私有协议到以太网底座,AI算力底座的每一个子系统路线图都已铺开。正如多位演讲者所言:下一代超节点的竞争,是工程深度与标准广度的竞争。
注:本文根据2026 ODX开放数据中心大会暨首届算博会计算分论坛各演讲专家分享材料整理,数据与观点均引自各演讲者分享内容,仅代表演讲专家自身实践与判断。